JupyterLab
Cette page présente l'usage recommandé de JupyterLab sur le cluster via Open OnDemand. Elle s'adresse à des utilisateurs de profils scientifiques variés et explique, de manière progressive, comment travailler de façon interactive sur un nœud de calcul, utiliser son propre environnement logiciel, puis lancer les calculs longs avec SLURM.
Finalité du service
JupyterLab est proposé comme un service interactif permettant de travailler directement sur un nœud de calcul à partir d'un navigateur web. Ce mode est adapté à la phase de mise au point : lecture de données, correction de scripts, validation d'une méthode, génération de figures, inspection de fichiers intermédiaires et tests sur des cas réduits.
Le service ne remplace pas les soumissions batch classiques. Une fois le code validé, les calculs longs, lourds ou reproductibles doivent être lancés via SLURM (par exemple avec sbatch slurm.sh).
Fonctionnement général
Le lancement de JupyterLab se fait depuis Open OnDemand, qui démarre une session interactive sur le cluster avec des ressources définies au préalable (durée, nombre de cœurs CPU, mémoire et, si nécessaire, GPU).
Il est utile de distinguer les éléments suivants :
| Élément | Rôle |
|---|---|
| Open OnDemand | Portail web d'accès aux services interactifs |
| JupyterLab | Interface de travail dans le navigateur |
| Environnement Conda/module | Bibliothèques et dépendances de votre projet |
| Kernel Jupyter | Interpréteur utilisé dans le notebook |
| SLURM | Système de soumission et de gestion des ressources |
JupyterLab fournit l'interface de travail, mais le contenu scientifique du notebook provient de votre environnement logiciel (module ou environnement Conda). Pour qu'un environnement Conda soit utilisable comme kernel Jupyter, il doit en général contenir au minimum ipykernel ou un kernelspec enregistré.
Choisir une session CPU ou GPU
Lors du lancement de JupyterLab dans Open OnDemand, vous pouvez devoir choisir un type de session :
- une session CPU est suffisante dans la grande majorité des cas (analyse de données, pré/post-traitement, visualisation légère, développement) ;
- une session GPU n’est utile que si votre code ou vos bibliothèques utilisent explicitement un GPU (CUDA, PyTorch, TensorFlow, etc.).
| Type de session | Cas d’usage typiques |
|---|---|
| CPU | Débogage, analyse, figures, pré/post-traitement, scripts classiques |
| GPU | Apprentissage profond, code CUDA, traitements explicitement GPU |
Si vous ne savez pas si vous avez besoin de GPU, choisissez CPU.
Workflow recommandé
Le workflow conseillé sur le cluster est le suivant :
- Préparer un environnement logiciel personnel (par exemple un environnement Conda ou un module dédié).
- Y installer les bibliothèques nécessaires au projet ainsi que de quoi exposer un kernel (souvent
ipykernel). - Lancer JupyterLab via Open OnDemand.
- Choisir le kernel correspondant à cet environnement.
- Tester, corriger, visualiser et valider vos traitements sur des cas réduits.
- Transférer ensuite la logique finale dans un script batch SLURM pour les calculs longs.
Cette séparation entre travail interactif et production batch est essentielle pour un usage propre et efficace du cluster.
Préparer son environnement personnel
Avant d’utiliser un environnement dans JupyterLab, il faut le créer, y installer les bibliothèques nécessaires et un kernel Jupyter.
Exemple minimal avec Conda (chemin à adapter à eXplor) :
source /soft/apps/manual/softwares/miniforge3/etc/profile.d/conda.sh

conda create -n mon-env python=3.11 numpy scipy matplotlib pandas -y
conda activate mon-env

# Installer le support kernel Jupyter
conda install -c conda-forge ipykernel -y
python -m ipykernel install --user --name mon-env --display-name "Python (mon-env)"
Dans la plupart des configurations Open OnDemand, il n’est pas nécessaire d’installer jupyterlab dans votre environnement personnel : le service Jupyter est fourni côté cluster, mais le kernel doit être présent dans votre environnement.
Pour plus de détails sur les environnements :
Lancer JupyterLab dans Open OnDemand
Procédure générale :
- Ouvrez le portail Open OnDemand.
- Dans Interactive Apps, sélectionnez JupyterLab.
- Choisissez :
- la partition (par exemple
debugpour des tests, ou une partition de calcul pour des analyses plus lourdes) ; - la durée de la session ;
- le nombre de cœurs CPU ;
- la mémoire ;
- éventuellement le nombre de GPU si nécessaire.
- la partition (par exemple
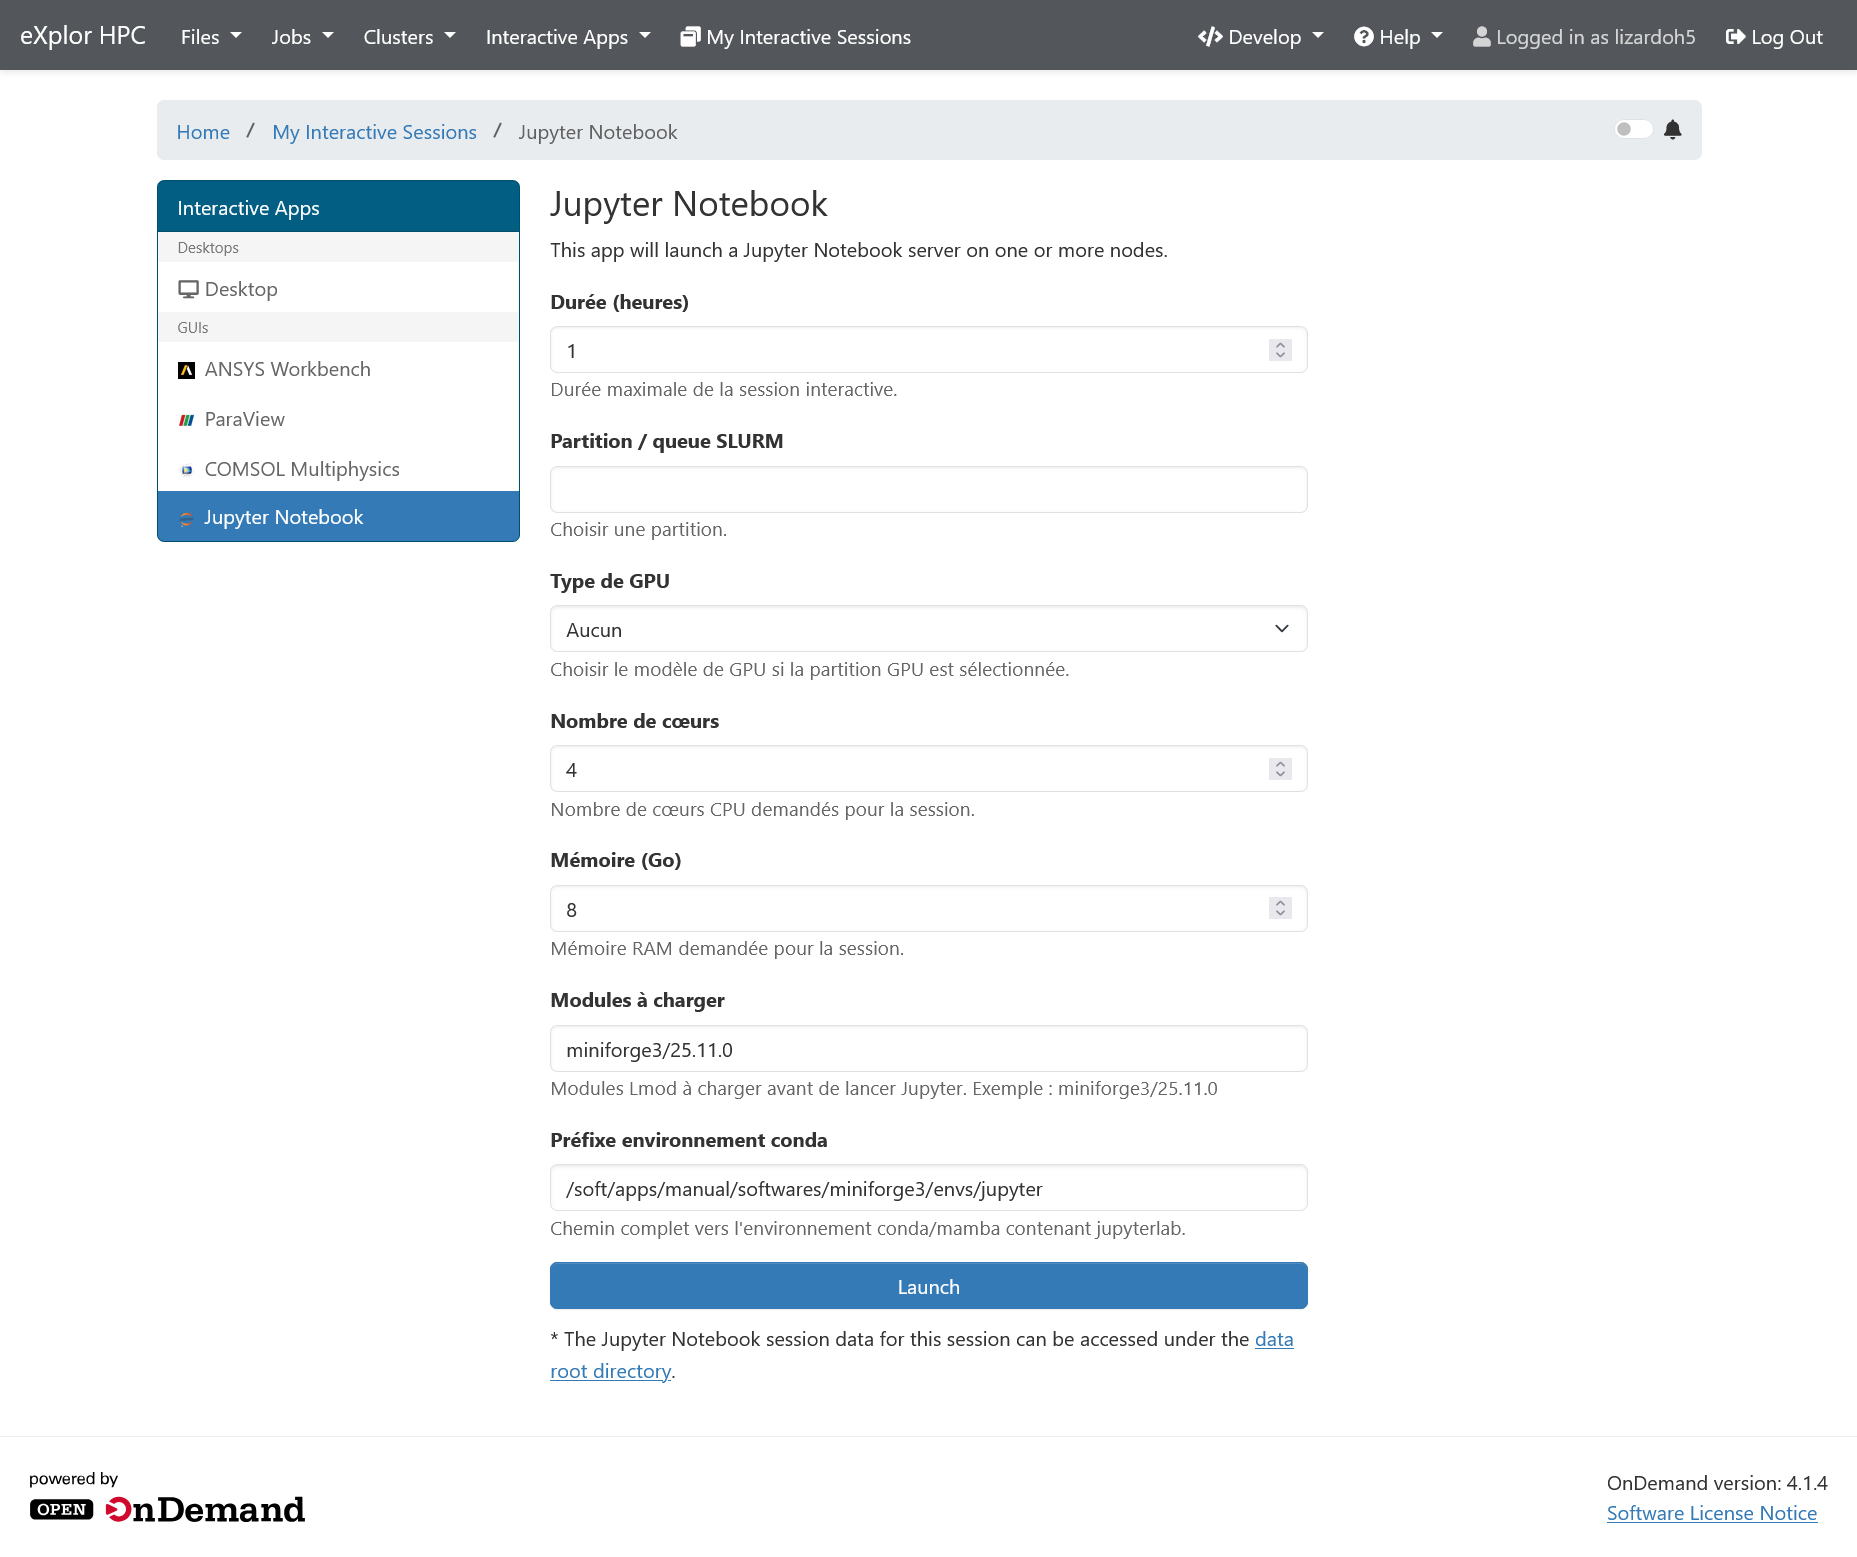
- Validez pour lancer la session.
- Une fois le job SLURM démarré, cliquez sur le lien pour ouvrir JupyterLab dans le navigateur.
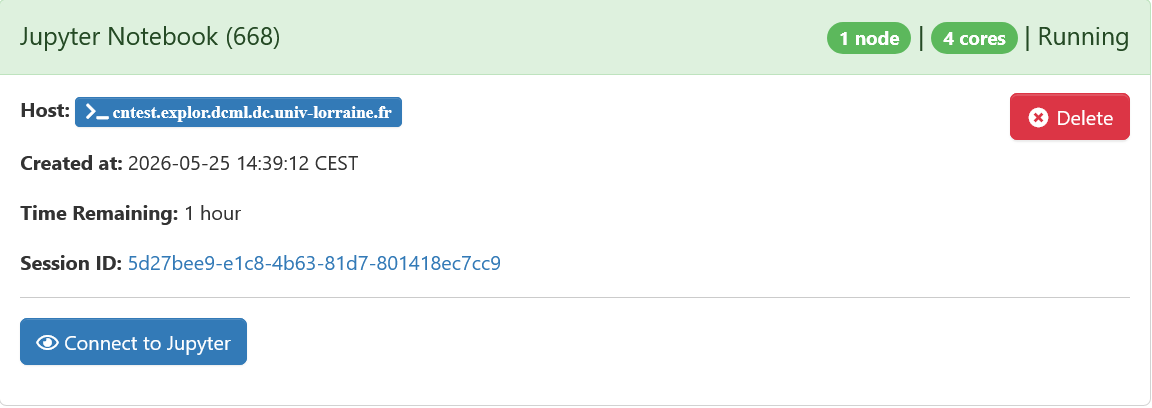
À ce stade, vous travaillez déjà sur un nœud de calcul, avec les ressources demandées.
Créer un nouveau notebook
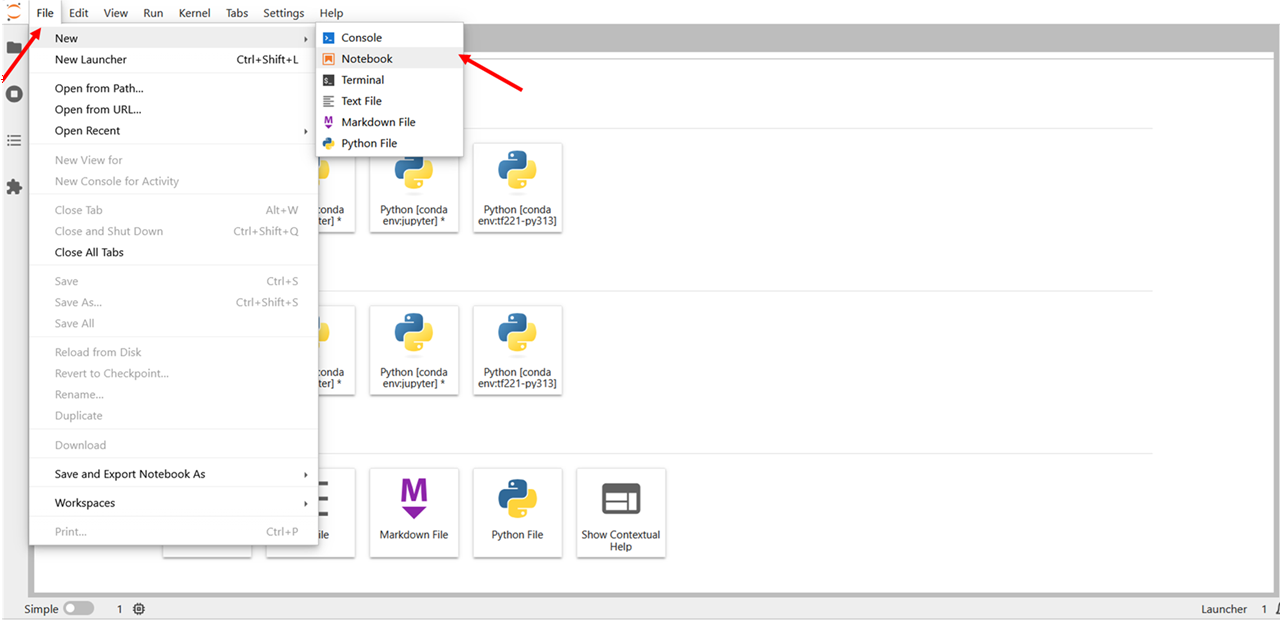
Une fois JupyterLab ouvert, la manière la plus simple de démarrer est de créer un nouveau notebook depuis le menu File :
- Dans la barre de menu, cliquer sur File.
- Choisir New → Notebook.
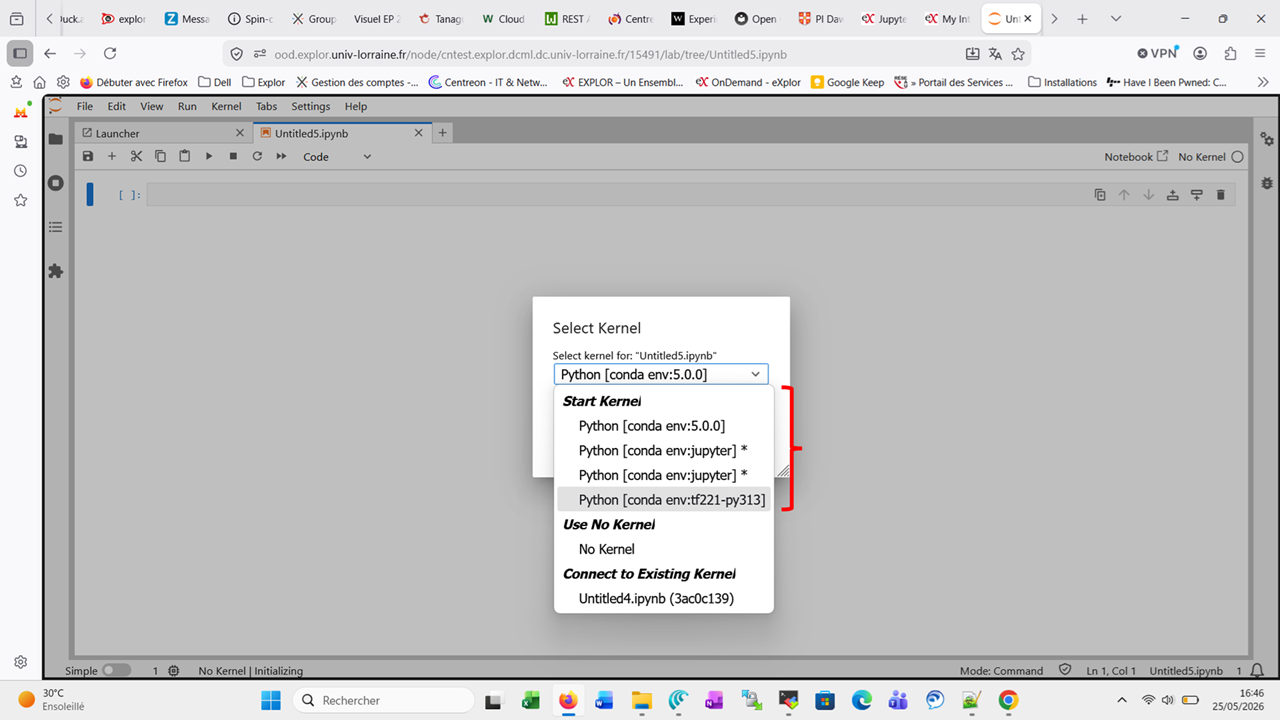
- Dans la boîte de dialogue qui s’ouvre, sélectionner le noyau (kernel) souhaité si plusieurs sont disponibles.
- Un nouveau notebook s’ouvre alors dans un onglet, prêt à être utilisé.
Vérification utile dans une cellule :
import sys
print(sys.executable)
Le chemin doit correspondre à l’environnement que vous souhaitez utiliser. Vous pouvez aussi vérifier la version de Python et de quelques bibliothèques :
import platform
print(platform.python_version())

import numpy
print(numpy.__version__)
Usages recommandés dans JupyterLab
JupyterLab est particulièrement adapté pour :
- déboguer un script ou un workflow ;
- tester une méthode sur un jeu de données réduit ;
- lire et inspecter des fichiers de sortie ;
- produire des figures ou des tableaux de synthèse ;
- mettre au point un post‑traitement avant de le transformer en script batch.
Exemple de lecture de fichier :
from pathlib import Path

f = Path("resultats/sortie.txt")
print(f.exists())
print(f.read_text()[:1000])
Exemple de figure simple :
import numpy as np
import matplotlib.pyplot as plt

x = np.linspace(0, 10, 200)
y = np.sin(x)

plt.plot(x, y)
plt.xlabel("x")
plt.ylabel("sin(x)")
plt.show()
Passage aux calculs longs (SLURM)
Une fois votre méthode validée dans JupyterLab, il est recommandé de :
- Extraire la logique principale dans un ou plusieurs scripts (par exemple
mon_script.py,posttraitement.sh, etc.). - Écrire un script SLURM qui active le même environnement et exécute ces scripts.
- Soumettre les jobs via
sbatchpour les calculs longs ou les campagnes.
Exemple minimal de script batch :
#!/bin/bash
#SBATCH --job-name=mon-calcul
#SBATCH --output=slurm-%j.out
#SBATCH --error=slurm-%j.err
#SBATCH --time=04:00:00
#SBATCH --cpus-per-task=4
#SBATCH --mem=8G

source /soft/apps/manual/softwares/miniforge3/etc/profile.d/conda.sh
conda activate mon-env

python mon_script.py
L’environnement activé dans le script batch doit être cohérent avec celui utilisé dans JupyterLab pendant la phase de mise au point.
Ce qu’il ne faut pas faire
Il n’est pas recommandé de :
- lancer des calculs très longs directement dans des cellules de notebook ;
- laisser des notebooks tourner en continu comme substitut à des jobs batch ;
- traiter des volumes de données massifs dans Jupyter avant d’avoir validé la méthode sur des cas réduits ;
- compter uniquement sur les notebooks pour la reproductibilité, sans script batch associé.
Dans ces cas, il faut transformer votre code en scripts et basculer vers des jobs SLURM.
Questions fréquentes
Mon environnement n’apparaît pas dans la liste des kernels
Vérifiez en priorité que :
ipykernelest bien installé dans l’environnement ;- le kernel a été enregistré (commande
python -m ipykernel install ...ou outil équivalent fourni par le mésocentre).
Si le problème persiste, contactez le support en indiquant :
- le nom de l’environnement ;
- les commandes utilisées pour le créer ;
- une capture de la liste des kernels disponibles dans JupyterLab.